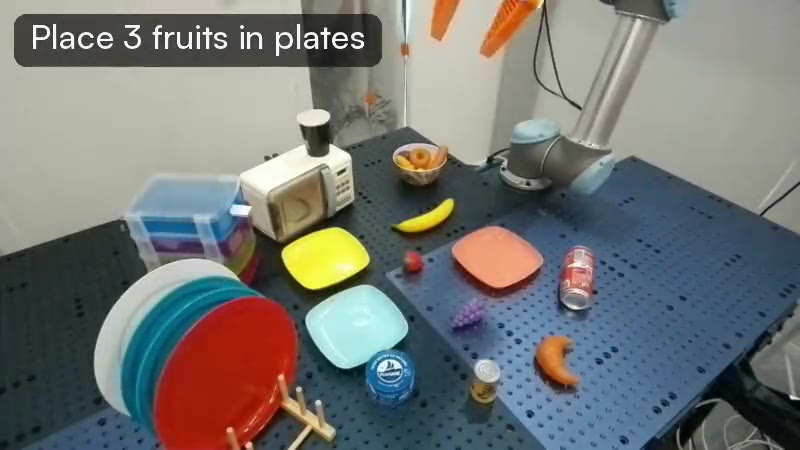
REKI: Registering Knowledge in VLAs
REKI是基于公开数据预训练的2.4B参数视觉语言动作模型(VLA)。作者在动作专家中引入寄存器token缓存每帧视觉语言模型输出,为策略提供低开销近期记忆,并在仿真和真实机器人上评估其效果。
论文
展开解读与证据
REKI是基于公开数据预训练的2.4B参数视觉语言动作模型(VLA)。作者在动作专家中引入寄存器token缓存每帧视觉语言模型输出,为策略提供低开销近期记忆,并在仿真和真实机器人上评估其效果。
为什么值得关注
为小型团队研究可复现VLA预训练,以及低开销历史上下文记忆提供具体模型和实现线索。
研究问题
机器人策略需要利用近期历史,但直接重复编码历史图像会增加推理开销,且分块动作生成易导致姿态振荡。
方法原理
视觉语言模型后接流匹配动作专家;少量寄存器token汇总每帧VLM输出,并持久保存在动作专家缓存中,作为近期记忆。
结果与证据
作者报告在仿真和实机评估中,加入记忆改善了任务成功表现,并使动作姿态间的振荡约少四倍。该结果限于原文评估配置,本期未独立复现。
阅读边界
本次依据工具返回的截断正文节选,未独立复现或逐项复核全部实验配置;不能把作者报告的局部结果外推为完整机器人系统的通用性能保证。
评论 · —
昵称自填。评论会展示给其他读者,请勿填写私人信息。

正在读取评论…